منصة تعليم عربية بالذكاء الاصطناعي
فهيم
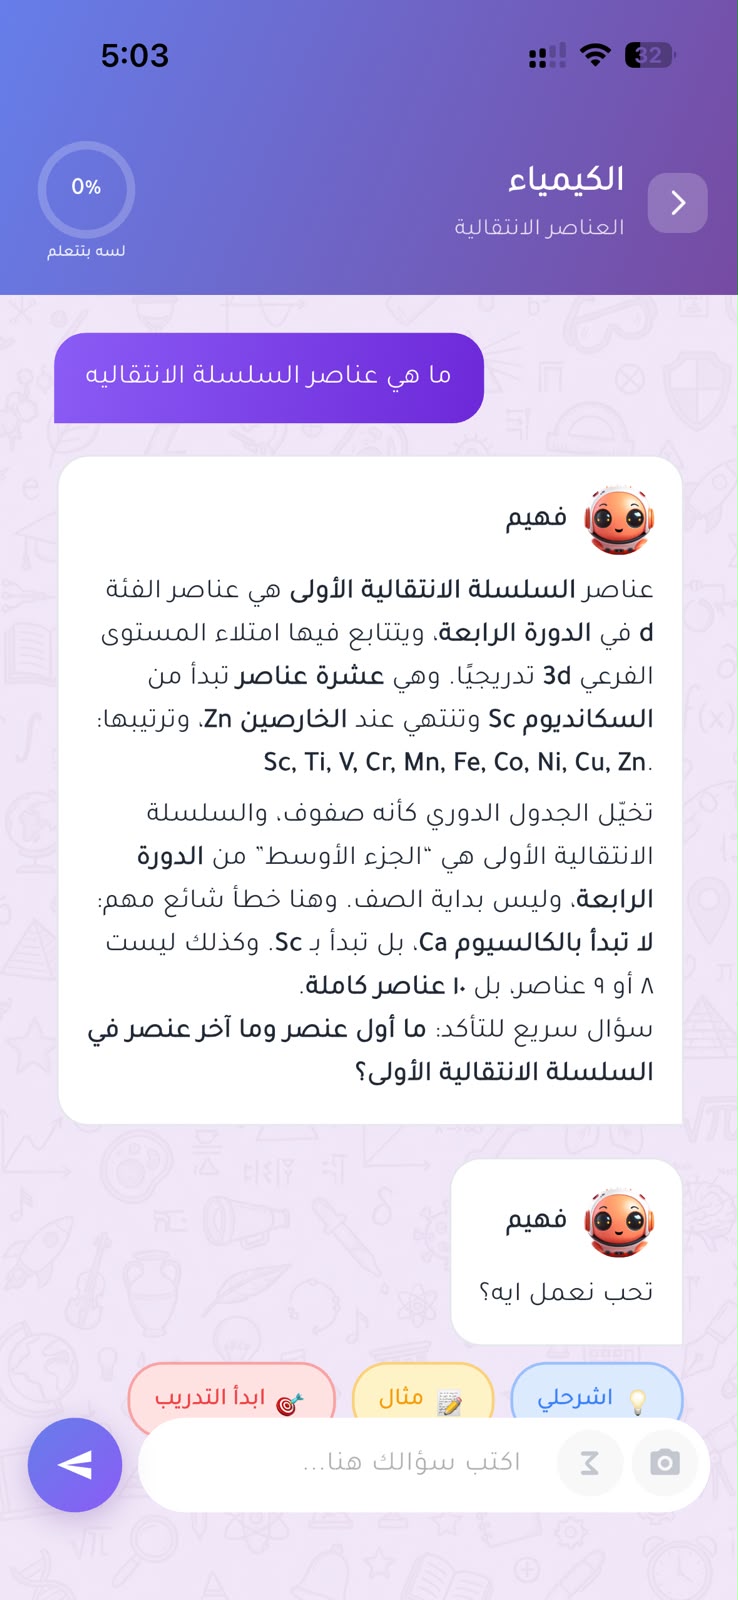
الطبقة الفورية في مدرّس عربي بالذكاء الاصطناعي لأكثر من 200,000 طالب: إجابات متدفّقة، ومحادثة صوتية بزمن 300–500 مللي ثانية تقريبًا، ودروس مولّدة — فوق بنية من 16 موديول بـ Clean Architecture.
التحدي
الطلاب احتاجوا تدريساً يبدو حياً وموثوقاً بالعربية — إجابات فورية، صوت، وصور — وليس روبوت محادثة عام مركّب على نموذج. والمدرّس الذي يتوقف ليفكّر يبدو معطّلًا في نظر طالب في الرابعة عشرة، لذا كان زمن الاستجابة متطلّبًا في المنتج لا تحسينًا لاحقًا.
ما كان عليه أن يحققه
- إجابات عربية تظهر أثناء توليدها، لا بعد توقف
- حوار صوتي بزمن ذهاب وعودة بين 300 و500 مللي ثانية تقريبًا، يستطيع الطالب مقاطعته — ولا يستطيع المعلّم مقاطعة نفسه
- دروس مولّدة بالذكاء الاصطناعي يبقى فيها الشرح الصوتي والترجمة والرسوم متزامنة
- واجهة عربية كاملة من اليمين لليسار
- بناءات منفصلة للتطوير والتجهيز والاختبار والإنتاج: التطبيق الرسمي للوزارة لا يُختبر على الإنتاج
دوري
مهندس أساسي على طبقة التدريس الفورية والبنية التي بُني عليها باقي المنتج.
كيف بنيته
- بناء تدريس AI فوري عبر WebSocket مع Azure OpenAI streaming بحيث تصل الإجابة كلمة بكلمة.
- بناء مدرّس صوتي بزمن ذهاب وعودة بين 300 و500 مللي ثانية تقريبًا، بتحويل الكلام إلى نص والعكس.
- بناء محرّك جلسات "اللوحة": دروس مولّدة بالذكاء الاصطناعي تُعرض كمشاهد متعدّدة الوسائط متدفّقة، بمزامنة دقيقة على مستوى الإطار بين الصوت والترجمة النصية الحيّة والرسوم المتحرّكة بـ CustomPainter لكل موضوع في المنهج.
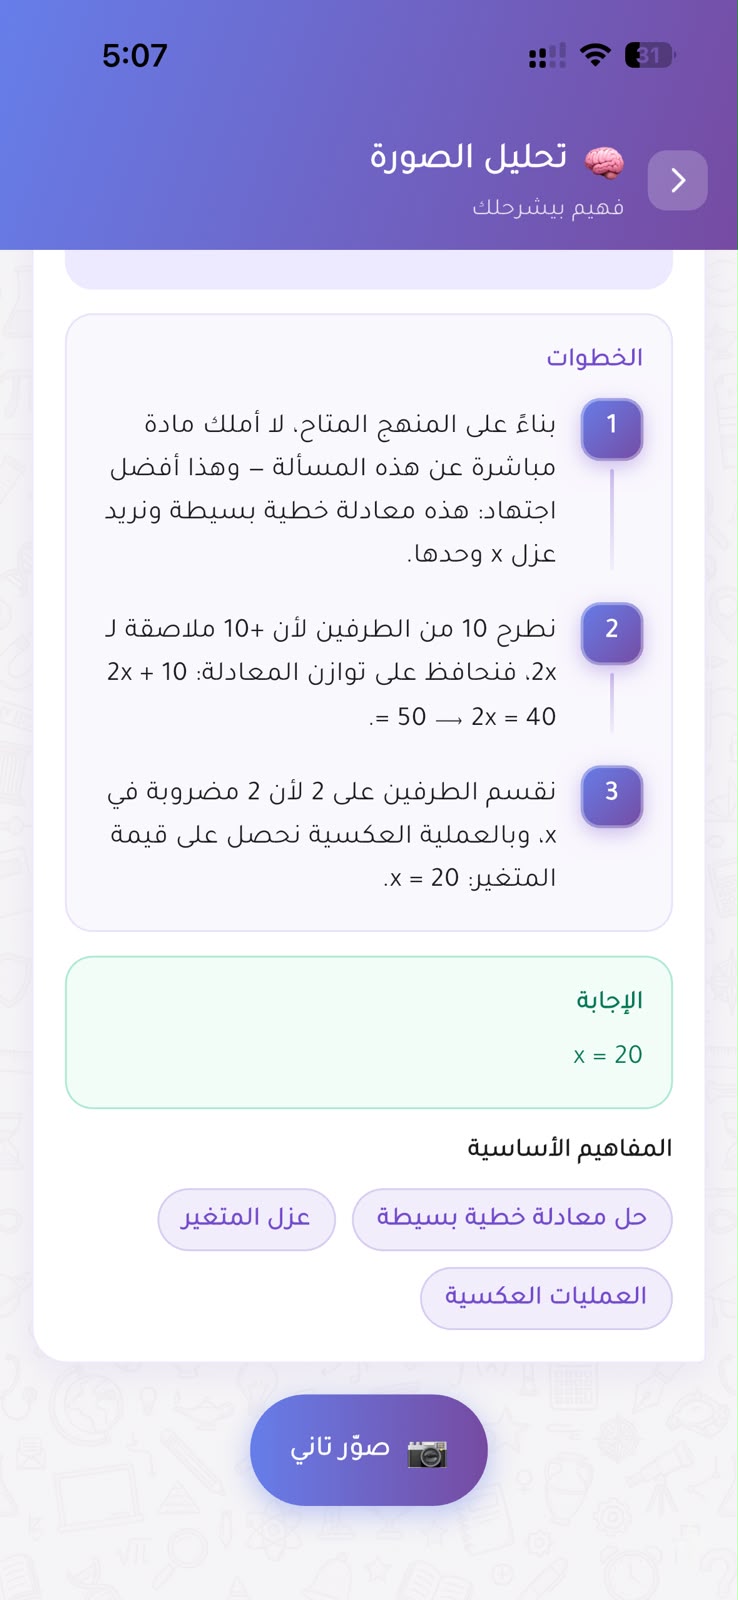
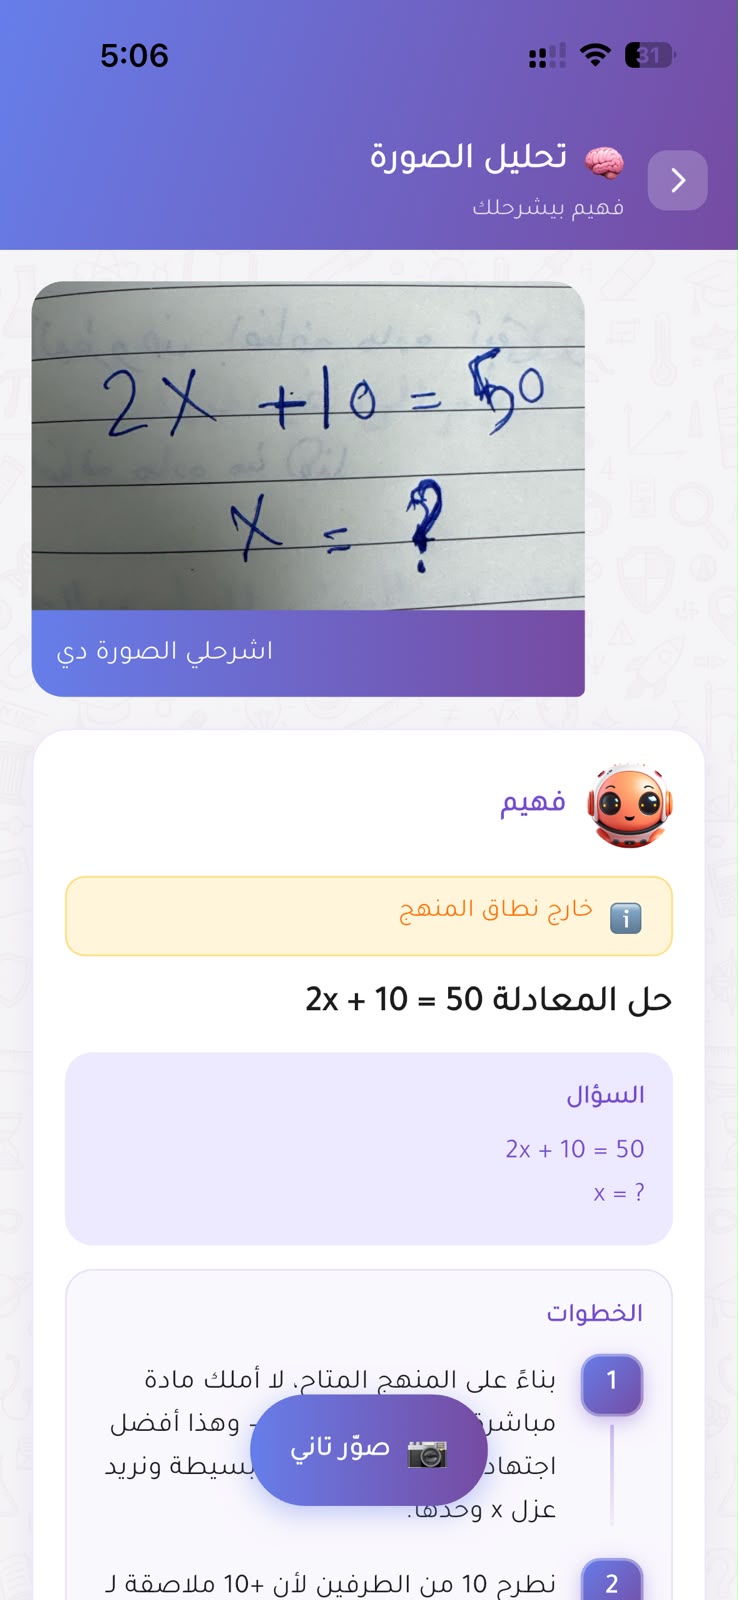
- إضافة اختبار ذكي تكيّفي بأسئلة مولّدة، وميزة حلّ بالكاميرا لمسائل الرياضيات والعلوم خطوة بخطوة.
- هيكلة 16 موديول بـ Clean Architecture (بيانات ← نطاق ← عرض) مع Provider و flutter_modular و Dio interceptors و dartz Either، وتعريب كامل يدعم RTL، ونحو 52 حدث تحليلات عبر 14 موديول، و Crashlytics و FCM وبيئات Dev/Staging/QA/Prod.
القرارات، ولماذا
WebSocket لا طلب واستجابة
المدرّس الذي يعيد فقرة كاملة يبدو معطّلًا حتى لو كان سريعًا — الطالب ينتظر مؤشّر تحميل. البثّ عبر اتصال دائم يضع أول كلمة على الشاشة في جزء صغير من زمن التوليد الكامل، والاتصال نفسه يحمل الجلسة الصوتية، فتبقى قناة واحدة مفتوحة بدل اثنتين.
صوت النظام الأصلي مع عتبات VAD، كي لا يقاطع النموذج نفسه
في الوضع الصوتي كان المدرّس يتفاعل مع صوته هو: كلامه يعود عبر الميكروفون فيُحوَّل إلى نص ويُعامَل كسؤال جديد من الطالب. تمرير التسجيل والتشغيل عبر صوت النظام الأصلي وضبط عتبات كشف النشاط الصوتي للمقاطعة حلّ المشكلة — يستطيع الطالب مقاطعة المدرّس في منتصف الجملة، وهو ما يجعلها محادثة حقيقية، ولم يعد المدرّس يقاطع نفسه.
300–500 مللي ثانية كميزانية لا كهدف
حُدّد الرقم أولًا وبُنيت كل طبقة لتتّسع داخله — بثّ لا تجميع، وصوت أصلي لا سلسلة إضافات، ولا معالجة بين التعرّف على الكلام والنموذج. التعامل معه كميزانية هو ما منعه من التمدّد مع كل ميزة جديدة.
مزامنة دقيقة على مستوى الإطار بدل ثلاثة مشغّلات منفصلة
الدرس المولّد يشغّل الصوت والترجمة النصية ورسمًا متحرّكًا في آن واحد. لو سار كلٌّ منها وحده لانحرفت المواعيد، ورسمٌ يشرح الجملة الخطأ أسوأ من غياب الرسم. محرّك اللوحة يشغّلها على خطّ زمني واحد، فيبقى الرسم والنص والصوت على الإيقاع نفسه.
أربع بيئات بناء منذ البداية
تطبيق هو المنتج الرسمي لوزارة التربية والتعليم لا يمكن اختباره على بيئة الإنتاج. أُعدّت بيئات Dev و Staging و QA و Prod قبل العمل على المزايا، ولهذا لم يرَ 200,000 طالب إصدار اختبار قط.
التقنيات
من داخل المنتج
كل تعليق يشرح ما تفعله الشاشة — وبعض هذه المنتجات واجهته بالعربية فقط.
شاهده مباشرة
تبني شيئًا مشابهًا؟
أخبرني بما تريد إطلاقه وسأقول لك بصراحة إن كنت الشخص المناسب لبنائه.